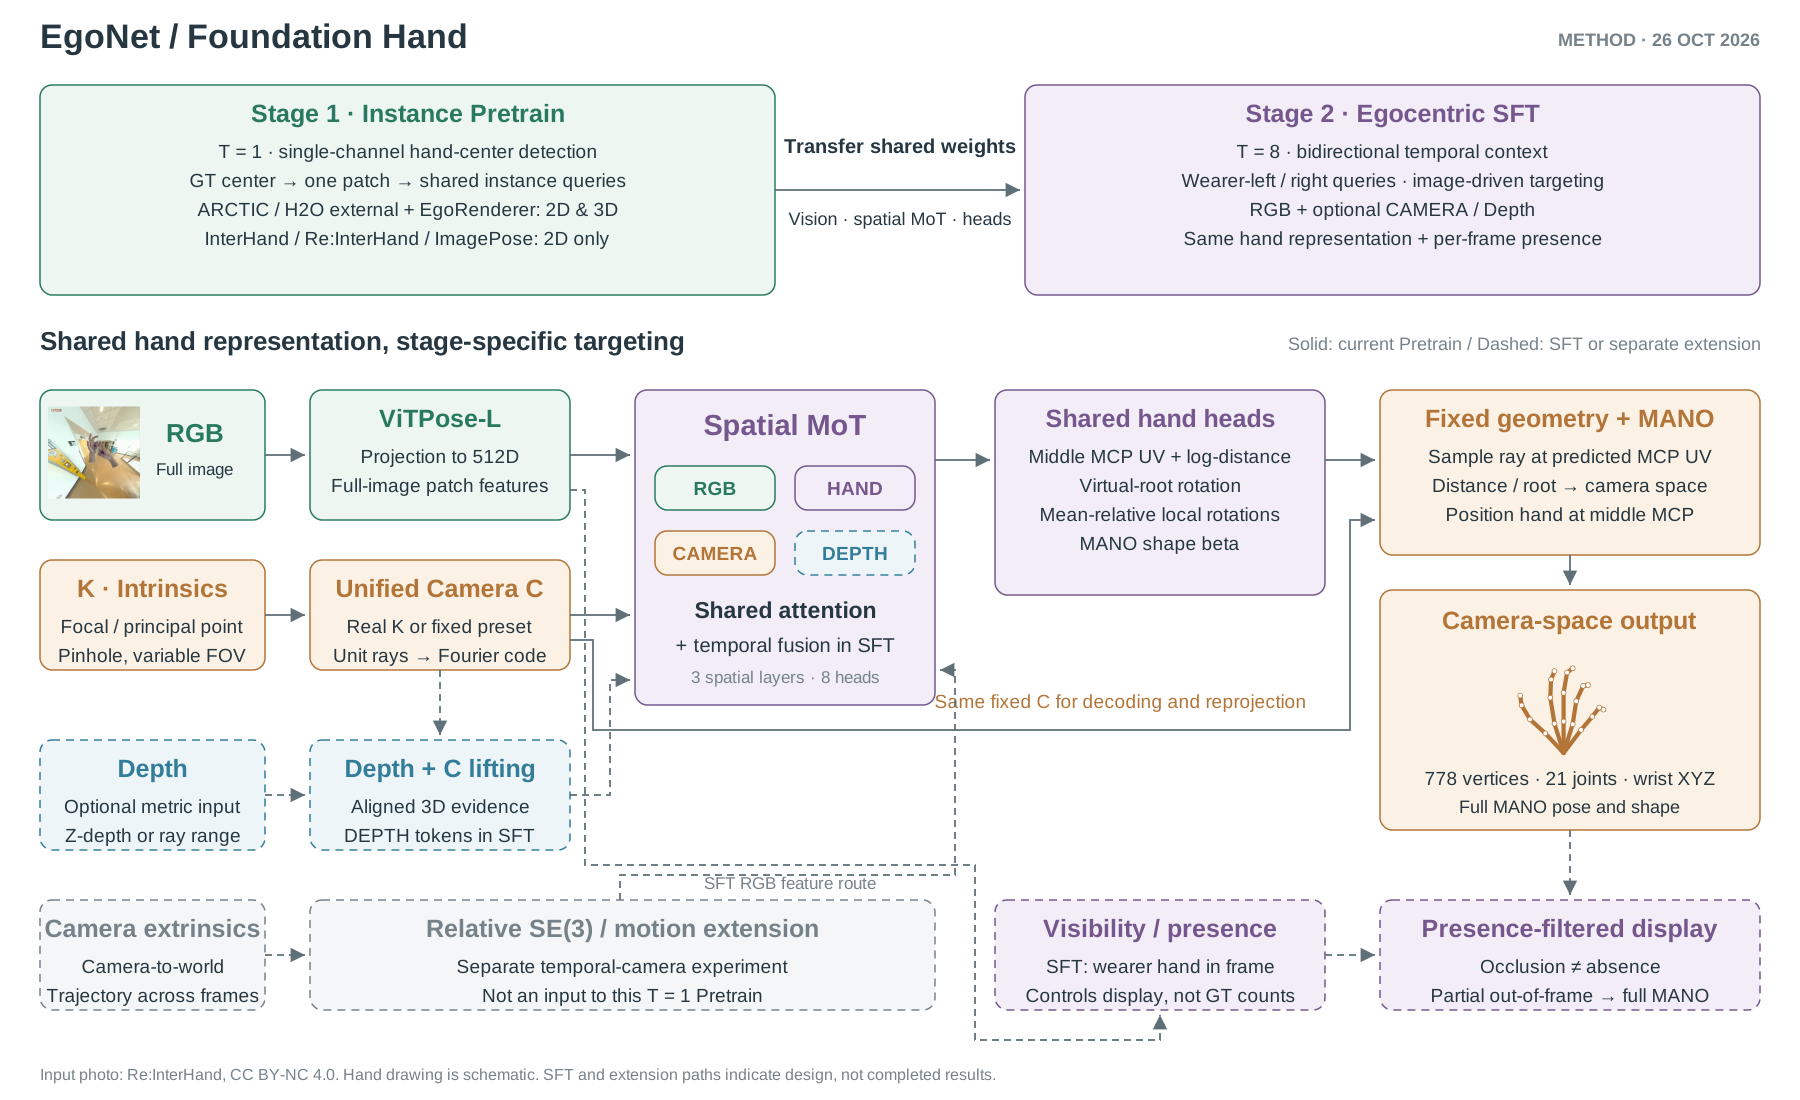

STAGE 01 / T = 1
Instance-level Pretrain
图中任意已标注手实例共享预测网络,不限制为一左一右。单通道中心图定位实例,训练时按 GT 中心纯采样一个 patch,构造共享 hand / joint queries。
训练视觉、空间 MoT、定位与 MANO heads。
展开数据、表征和训练细节
GT side 仅选择匹配的 MANO 资产、mean 和监督统计,不进入可学习 query。模型预测 MCP UV、虚拟 log-distance、virtual-root 6D、local mean-delta 6D 与 β。
| 来源 | 比例 | 监督 |
|---|---|---|
| ARCTIC 第三人称 | 25% | 2D + 有效 canonical 3D |
| H2O 第三人称 | 15% | 2D + 有效 canonical 3D |
| EgoRenderer | 20% | 2D + fitted 几何 / pose;β loss 关闭 |
| InterHand | 12% | 仅 2D |
| Re:InterHand | 15% | 仅 2D |
| COCO / HInt | 8% / 4% | 仅 2D |
| MPII / NZSL | 各 0.5% | 仅 2D |
ViTPose-L 以官方 COCO 视觉权重初始化,其余任务参数新建。首版三档画布为 512×896 / 368×640 / 512×512,比例 50% / 20% / 30%;完整图像等比缩放并 padding。
初始预算 120K optimizer updates,global batch 32,即 384 万次图像曝光;每 5K 保存。前 5K 不更新视觉权重,之后联合训练视觉 last-2 和 final norm。120K 是预算,不是收敛结论。
当前 Pretrain 不训练 Depth、temporal 或 wearer presence。这些模块在 SFT 中单独接入。